2 Corrección Geométrica
Corrección geométrica y redistribución proporcional de atributos
2.1 ¿Por qué fue necesaria esta corrección?
Durante la actualización de la matriz MBHT con base en el Censo 2024, se detectó un problema en la información espacial a nivel de manzana y entidades rurales: en algunos casos, un mismo ID censal estaba asociado a más de un polígono físicamente separado.
Esto genera una inconsistencia importante, porque desde el punto de vista cartográfico y analítico una unidad censal con un único identificador debería representar una geometría coherente. Cuando un mismo ID aparece en polígonos separados, pueden producirse errores en:
- La visualización de resultados,
- La agregación y desagregación de variables,
- El cálculo de indicadores territoriales,
- La interpretación espacial de los datos.
Por esta razón, fue necesario implementar una metodología de corrección geométrica que permitiera separar estos casos en polígonos independientes, asignarles nuevos identificadores y redistribuir correctamente la información de sus tablas de atributos.
2.2 Tipos de Problemas
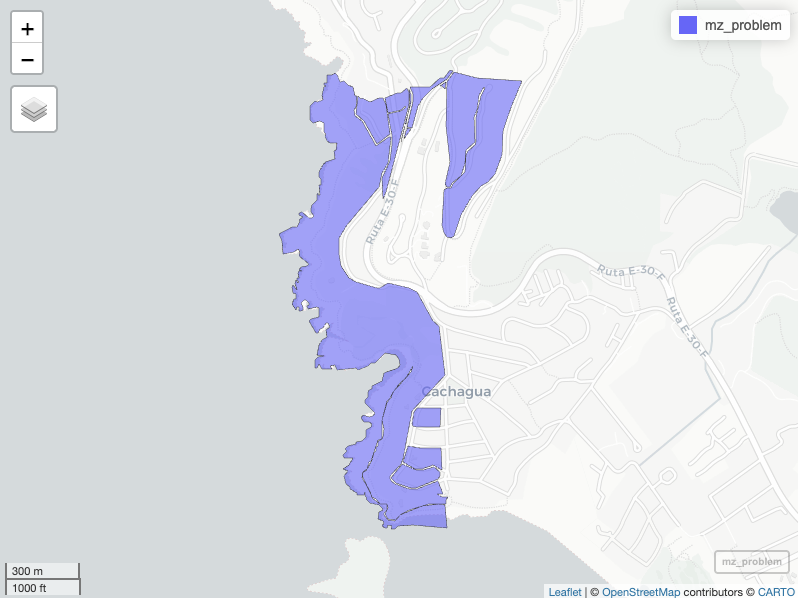
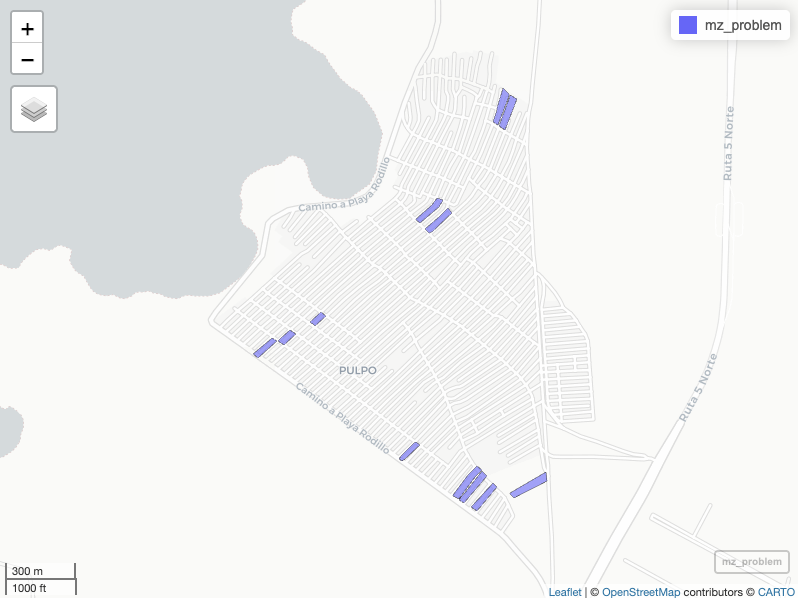
El problema observado puede resumirse así: Un ID censal único (por ejemplo, una manzana o entidad rural) aparece representado por múltiples polígonos. Estos polígonos pueden estar contiguos (parte de una misma unidad con geometría multipart) Figura 2.1 (a), o separados espacialmente de forma evidente (casos problemáticos) Figura 2.1 (b), como se observa en la siguientes figuras:
Desde el punto de vista del procesamiento, esto obliga a responder una pregunta clave:
Si una unidad censal original se divide en varios polígonos independientes, ¿cómo se distribuyen sus atributos en los nuevos polígonos resultantes?
La respuesta adoptada en esta metodología fue una distribución proporcional basada en la presencia de edificaciones, utilizando un archivo nacional de buildings (huellas de edificaciones).
2.3 Principio de redistribución
La metodología se basa en un principio simple pero fundamental: cuando un ID censal original debe separarse en más de un polígono, la información asociada a ese ID no puede copiarse de forma idéntica en cada parte, sino que debe redistribuirse proporcionalmente. Para ello, se utiliza como criterio la cantidad y/o superficie de edificaciones contenidas en cada polígono resultante. Esta decisión metodológica busca que la distribución de atributos refleje mejor la ocupación real del espacio, en lugar de depender únicamente del área del terreno.
El uso de edificaciones como base de redistribución responde a una razón analítica importante: en términos censales y territoriales, la huella construida suele representar de mejor manera la intensidad de uso del espacio. En la práctica, dos polígonos pueden tener áreas similares, pero una concentración muy distinta de construcciones. Por ello, distribuir atributos en función de edificaciones permite una asignación más realista y más consistente con la estructura territorial observada.
Este procedimiento se aplica solo cuando un mismo ID está representado por más de un polígono. Si una geometría corresponde a un único polígono, no se requiere redistribución. En cambio, cuando el ID se divide en múltiples partes, se calcula un peso de diseminación para cada una de ellas, que luego permite repartir los atributos del registro original de forma proporcional.
Objetivo del procedimiento
El objetivo del flujo, por tanto, es calcular para cada parte geométrica un peso (w) que permita transferir atributos desde el ID original hacia los nuevos polígonos corregidos. En términos generales, cada polígono resultante recibe un peso y, dentro de cada ID original fragmentado, la suma de esos pesos debe ser igual a 1. Esto asegura que la redistribución mantenga consistencia interna y que posteriormente las variables puedan desagregarse sin alterar el total original.
Enfoque general
A nivel de implementación, el procesamiento se organiza en dos ramas principales que siguen la misma lógica metodológica: una para manzanas (mz_*) y otra para entidades rurales (ent_*). Aunque se aplican sobre unidades espaciales distintas, ambas ramas comparten el mismo enfoque de corrección y redistribución. En su diseño general, el flujo prioriza cuatro criterios: consistencia geométrica, para asegurar que las unidades corregidas sean espacialmente válidas; eficiencia computacional, para procesar grandes volúmenes de datos; reproducibilidad, para poder repetir y auditar el procedimiento; y escalabilidad nacional, considerando que el procesamiento utiliza información espacial de cobertura nacional.
2.4 Explicación paso a paso del proceso
Ingesta y preparación de geometrías
En esta etapa se leen las capas espaciales desde la base de datos (DuckDB) y se realiza una preparación inicial para asegurar que el procesamiento posterior sea confiable.
Qué se hace en esta etapa
- Lectura de las capas espaciales (manzanas y entidades).
- Estandarización del sistema de coordenadas (CRS).
- Validación y corrección de geometrías inválidas (
st_make_valid). - Cálculo del área base de cada geometría.
Esta etapa asegura que las operaciones posteriores —como intersecciones, asignación de edificios o cálculos de superficie— se ejecuten sobre una base geométrica confiable. En términos prácticos, aquí se evita que errores de geometría se propaguen al resto del flujo.
Identificación de casos problemáticos y separación de partes
No todos los IDs con geometría multipart generan problemas analíticos, por lo que se evalúa si existen múltiples partes y qué tan separadas están entre sí. Para ello, se calcula la distancia de cada parte respecto del centroide del conjunto, y si alguna supera el umbral definido (por ejemplo, 500 metros) se marca como caso sospechoso y se considera candidata a una validación más detallada con edificaciones.
Como resultado, se construye un maestro de partes geométricas (donde cada parte recibe un ID derivado) y, en paralelo, un subconjunto de partes sospechosas que será analizado con edificaciones. Esta separación permite concentrar el esfuerzo computacional donde realmente importa.
Construcción de una caché de edificaciones para las zonas relevantes
Una vez identificadas las geometrías que requieren validación, se extraen únicamente las edificaciones relevantes desde el archivo nacional de buildings pero dentro de un hexágono h3 específico, quedándose con edificaciones necesarias.
Qué se hace
- Se agrupan zonas a procesar en lotes espaciales (batches).
- Se leen edificaciones solo dentro del área de interés (con un pequeño buffer).
- Las edificaciones se transforman a una representación más eficiente para consulta (puntos representativos + indexación H3).
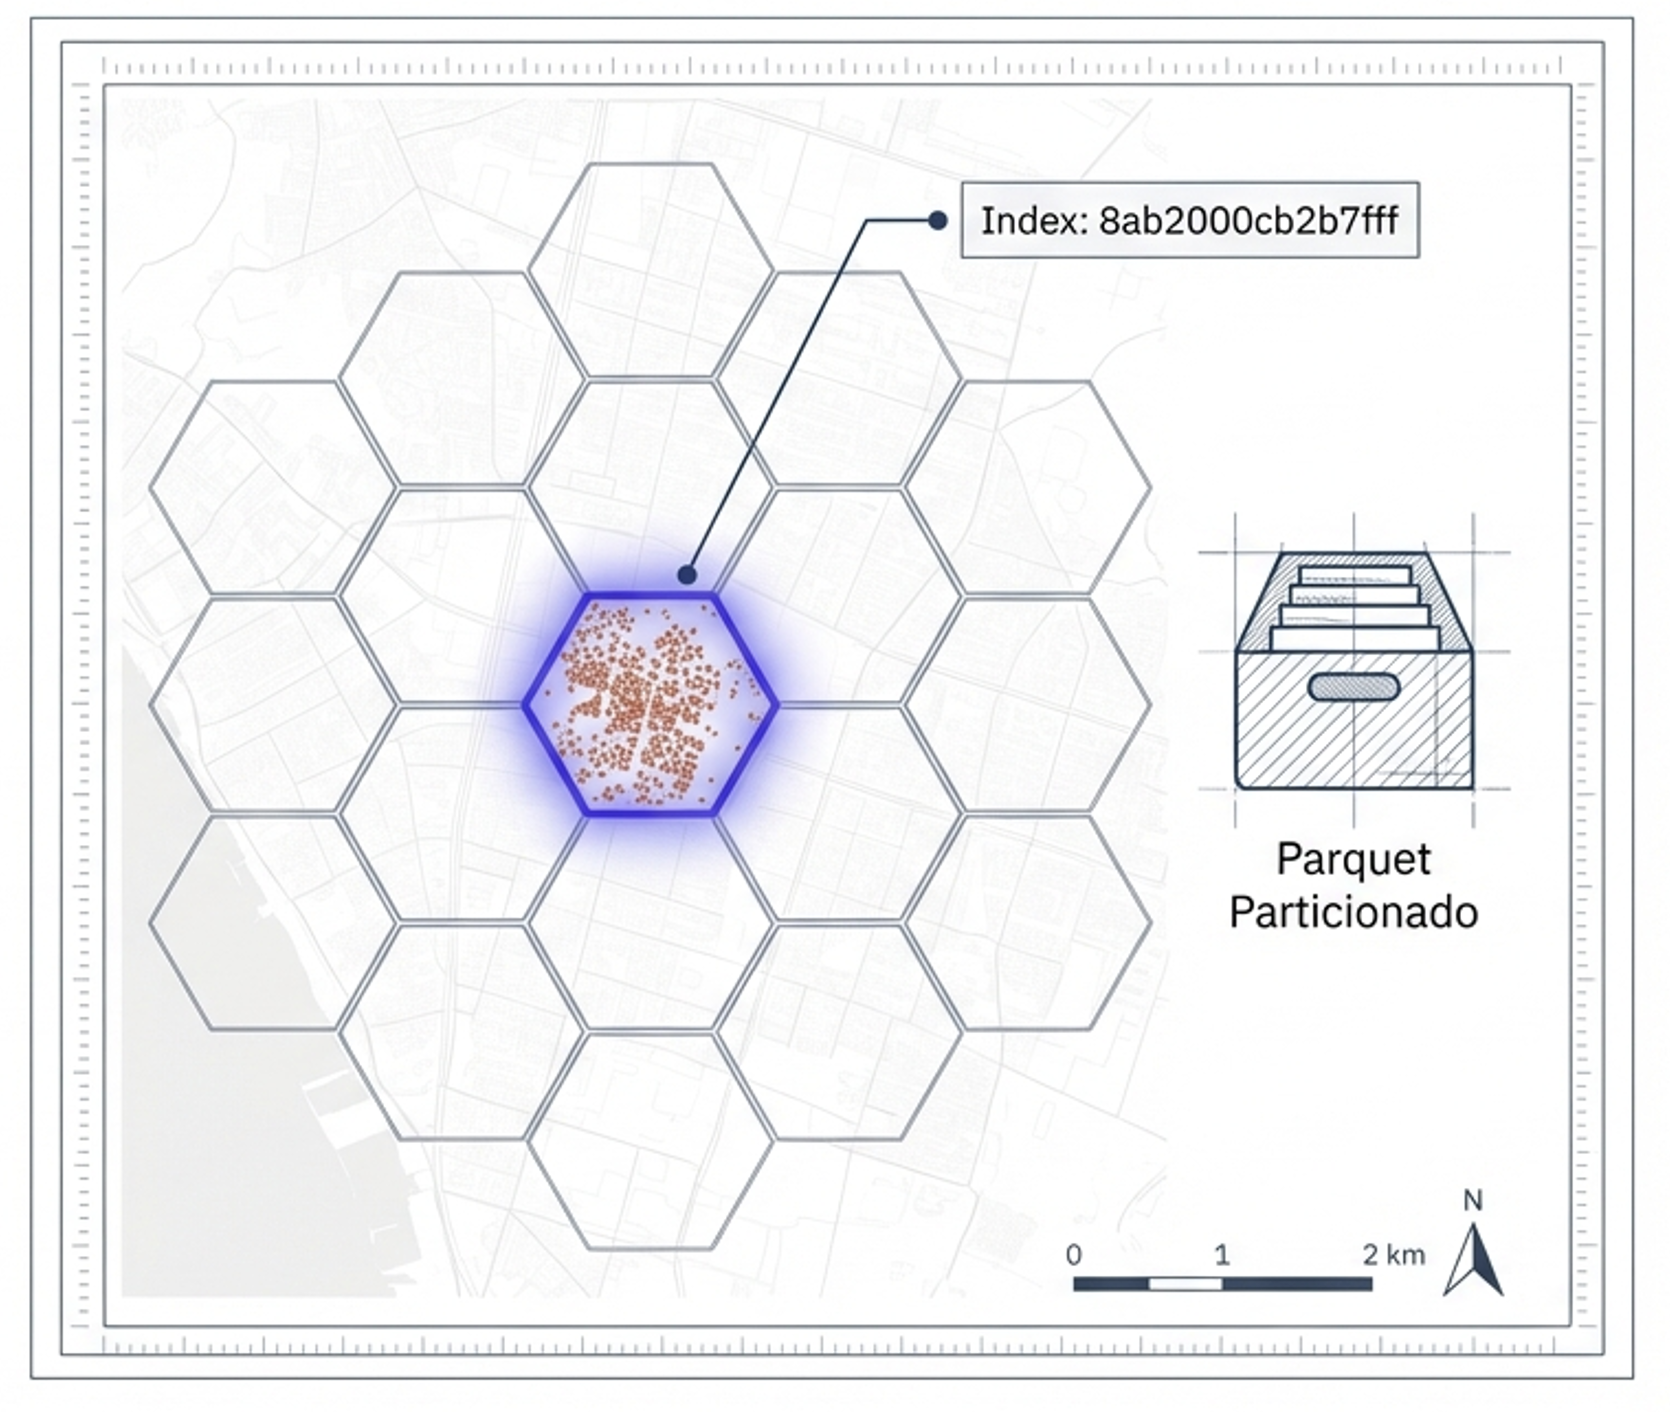
- Se guarda una caché intermedia en formato Parquet particionado (Figura 2.2).
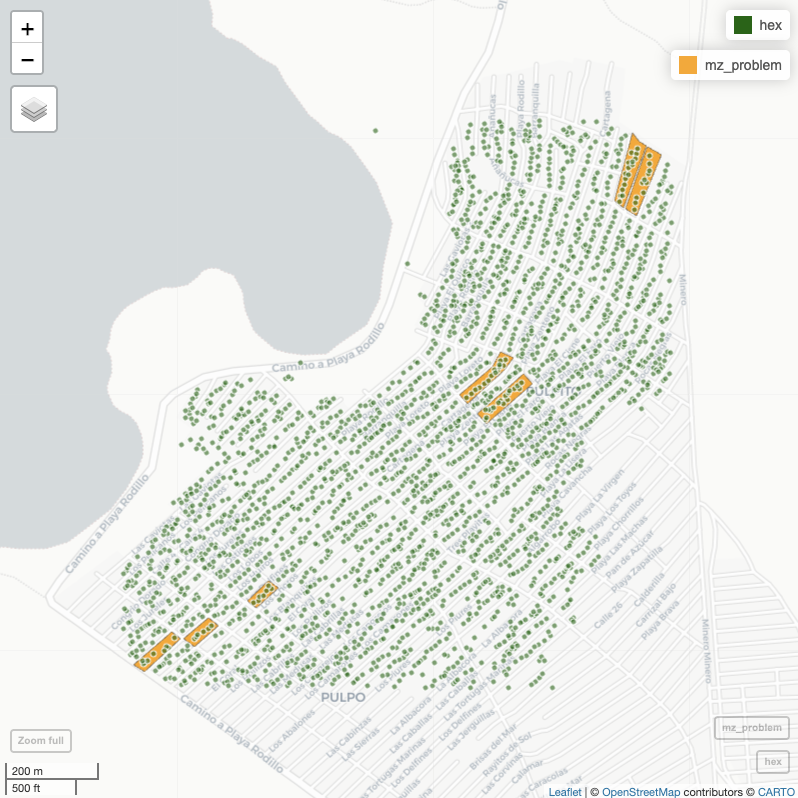
8ab2000cb2b7fff asociado a las Manzanas color naranja.
Esta información se almacena en Parquet particionado, lo que reduce de forma importante el costo de lectura/escritura (I/O) y acelera el procesamiento global en las etapas siguientes.
Cálculo intensivo de estadísticas por polígono
Esta es la etapa de cálculo intensivo, donde se determina cuántas edificaciones (y/o cuánta superficie construida) corresponden a cada parte de un ID dividido.
Qué se hace en términos generales
Para cada lote de polígonos:
- Se cargan las edificaciones candidatas desde la caché.
- Se realiza la asignación espacial de edificios a polígonos (point-in-polygon) (Figura 2.3).
- Se calculan estadísticas por parte geométrica, como:
- número de edificaciones (
n_buildings) - suma de área de edificaciones (
area_sum)
- número de edificaciones (
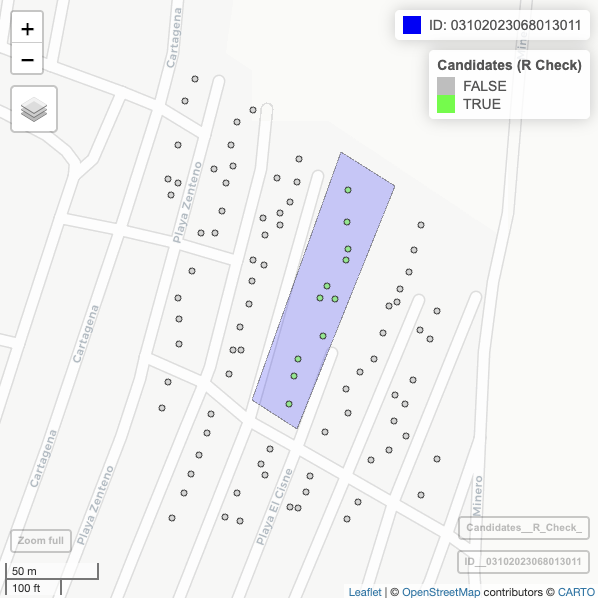
Por qué se integró Rust
Porque el cruce geométrico a gran escala (millones de edificios vs. miles de polígonos) puede ser muy costoso en tiempo si se ejecuta de manera tradicional. La integración con Rust permite acelerar el núcleo del cálculo y hacer viable el procesamiento a escala nacional.
Cálculo de pesos de redistribución y consolidación
Una vez obtenidas las estadísticas de edificaciones, se calcula el peso de redistribución para cada parte geométrica. La regla principal consiste en asignar pesos proporcionales a la evidencia construida observada dentro de cada parte de un mismo ID original. En términos generales, esto se expresa como la razón entre la medida de edificaciones de una parte en este caso por área construida (podría ser por conteo o área construida, según configuración) y el total de esa misma medida en todas las partes del ID original.
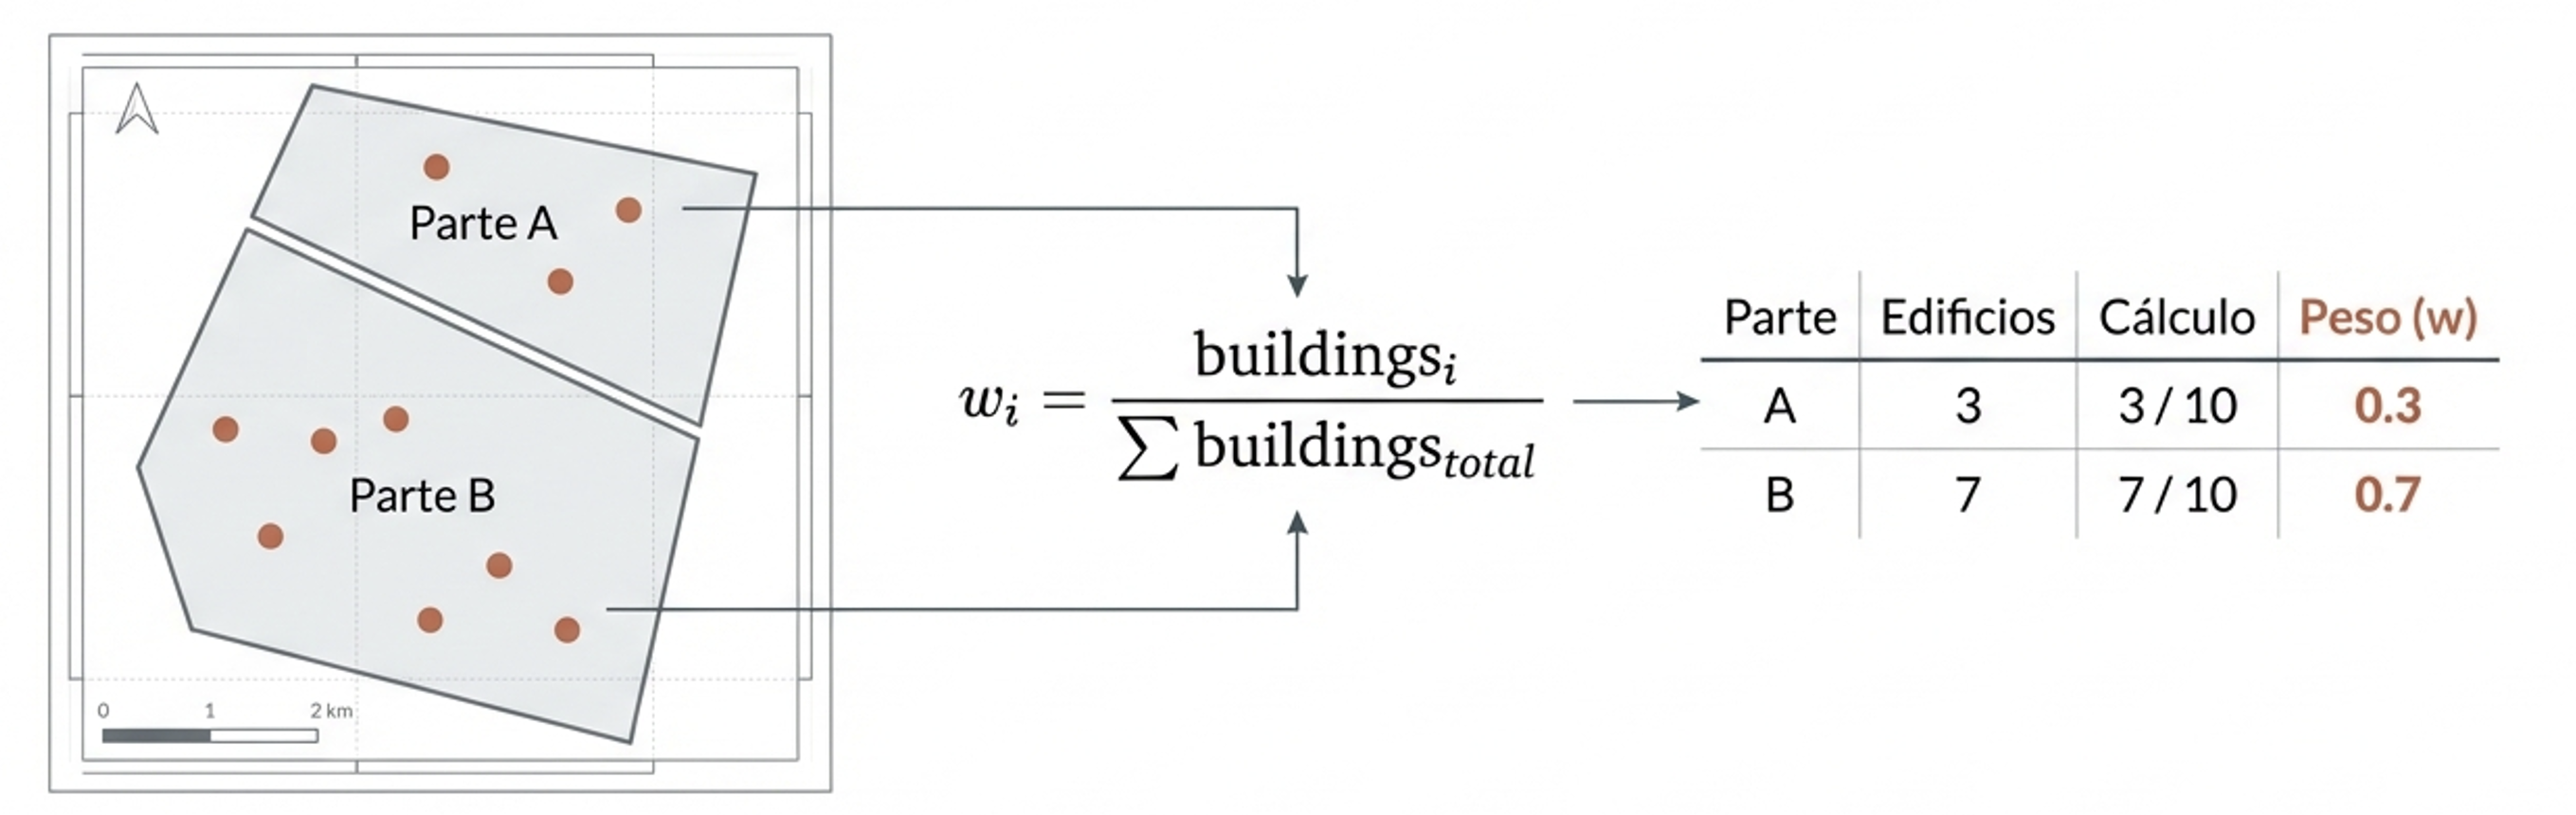
Una forma general de expresarlo es:
w_i = \frac{\text{medida de edificaciones en la parte } i}{\sum \text{medida de edificaciones de todas las partes del mismo ID}}
Donde la “medida” puede corresponder, según la configuración del flujo, al área total de edificaciones y/o a su conteo.
Cuando no se detectan edificaciones o no corresponde aplicar el cálculo intensivo, se utiliza un método de respaldo (fallback), como distribución proporcional al área del terreno (by_area) o uniforme (uniform).
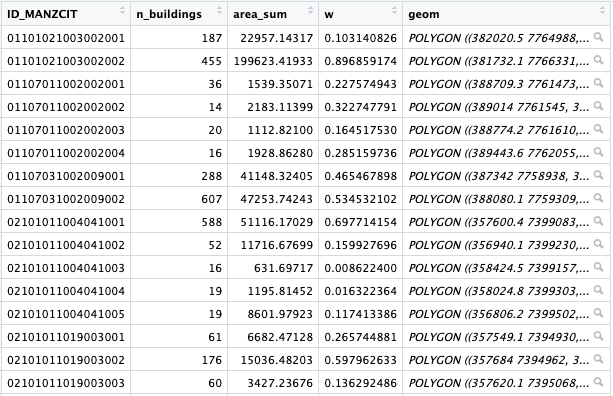
El resultado de esta etapa es un dataset consolidado en el que cada parte queda asociada a su ID derivado, su ID original, las estadísticas de edificios (cuando existen) y su peso final de redistribución (Figura 2.4). Con ello, la información queda preparada para desagregar los atributos que se deseen.
Generación de salidas para análisis y uso posterior
Generación de salidas para análisis, validación e integración. Finalmente, los resultados se exportan en varios formatos para facilitar su uso en distintas etapas del trabajo. Se genera una salida en Parquet para análisis rápido en R/Python y procesamiento masivo, una salida en GeoPackage (GPKG) para revisión cartográfica en software SIG, y tablas en DuckDB para reintegrar el resultado al repositorio central y al pipeline de indicadores. Mantener estas tres salidas en paralelo permite combinar rendimiento analítico, control visual y continuidad operativa dentro del proceso general de actualización de la matriz MBHT.